本記事は、筆者が独自に作成した解答・解説です。
統計検定の問題は、当サイトでは掲載していません。
統計検定の問題や公式の解説は、公式問題集をご参照ください。
『統計検定1級 公式問題集[2019~2022年]』をAmazonで見る
- 本記事は、統計検定の公式の解答・解説ではありません。
- 内容の正確性には配慮していますが、誤りが含まれている場合があります。
- 統計検定®は一般財団法人統計質保証推進協会の登録商標です。
解答
[1]
クラスター分析は、観測した特徴が似ている対象を同じグループにまとめる方法であり、そのグループをクラスターという。 ここでは、各マンションを築年数と所要時間の二つの値を座標とする点で表し、ユークリッド距離が小さいほど似ていると考える。 ここで用いる階層的な方法では、一つの点を一つのクラスターとして出発し、最も近い二つのクラスターを順に結合する。 結合の順序とその距離を木の形で表した図がデンドログラムである。
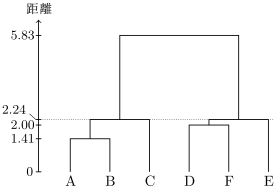
最短距離法では、異なるクラスターに属する点の組の距離の最小値を、クラスター間の距離とする。 したがって、群の中心同士ではなく、二つの群を結ぶ最も近い点同士の距離で判断する。 例えば、AとBの距離は \[ d(A,B)=\sqrt{(1-2)^2+(3-2)^2}=\sqrt{2}\approx 1.41 \] である。 これがすべての点の組の中で最小なので、最初にAとBを結合する。 次の最小距離は\(d(D,F)=2\)であり、DとFを結合する。 残るクラスターのうち \[ d(\{A,B\},\{C\})=\min\{d(A,C),d(B,C)\}=\sqrt{5} \] であり、\(d(\{D,F\},\{E\})\)も\(\sqrt{5}\)である。 これら以外のクラスター間の距離はすべて\(\sqrt{5}\)より大きいので、同じ高さ\(\sqrt{5}\approx 2.24\)でCと\(\{A,B\}\)、Eと\(\{D,F\}\)がそれぞれ結合する。 最後は \[ d(\{A,B,C\},\{D,E,F\})=d(C,E)=\sqrt{34}\approx 5.83 \] で結合し、次のデンドログラムを得る。 縦軸は結合距離を表す。 枝が低い位置でつながるほど、小さい距離で同じ群になったことを示す。
[2]
図を高さ\(h\)で水平に切ると、その高さより下でつながっている点を同じクラスターとして取り出せる。 結合点を避けて水平に切るなら、\(\sqrt{5}<h<\sqrt{34}\)、すなわち約\(2.24\)から\(5.83\)の間の高さ\(h\)で切ればよい。 得られる二つのクラスターは\(\{A,B,C\}\)と\(\{D,E,F\}\)である。 端点を含める規約を採る場合、距離が\(h\)未満の結合まで実行するなら\(\sqrt{5}<h\leq\sqrt{34}\)、\(h\)以下の結合まで実行するなら\(\sqrt{5}\leq h<\sqrt{34}\)となる。
[3]
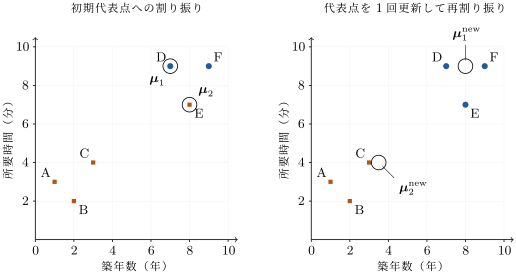
k-means法では、クラスター数\(k\)を先に決め、各点を最も近い代表点へ割り振る操作と、代表点をその群の平均へ更新する操作を交互に行う。 [1]で用いた階層的な方法とは異なり、更新の途中で点が別の群へ移ることがある。 ここでは\(k=2\)で、初期代表点を\(\boldsymbol{\mu}_1=(7,9)\), \(\boldsymbol{\mu}_2=(8,7)\)とする。 距離と距離の二乗は大小関係が同じなので、各点から代表点までの距離の二乗を比較する。 例えばAでは \[ \begin{aligned} \|(1,3)-(7,9)\|^2&=(1-7)^2+(3-9)^2=72 \\ \|(1,3)-(8,7)\|^2&=(1-8)^2+(3-7)^2=65 \end{aligned} \] となる。 \(65<72\)なので、Aはクラスター2へ割り振る。 表の\(\boldsymbol{x}\)は、各マンションの二つの座標をまとめたものである。 同様に計算すると次の表になる。
| 点 | \(\Vert\boldsymbol{x}-\boldsymbol{\mu}_1\Vert^2\) | \(\Vert\boldsymbol{x}-\boldsymbol{\mu}_2\Vert^2\) | 割り振り先 |
|---|---|---|---|
| A | \(72\) | \(65\) | \(2\) |
| B | \(74\) | \(61\) | \(2\) |
| C | \(41\) | \(34\) | \(2\) |
| D | \(0\) | \(5\) | \(1\) |
| E | \(5\) | \(0\) | \(2\) |
| F | \(4\) | \(5\) | \(1\) |
よって、初期のクラスターは\(\{D,F\}\)と\(\{A,B,C,E\}\)である。 それぞれの平均へ代表点を1回更新すると \[ \begin{aligned} \boldsymbol{\mu}_1^{\mathrm{new}}&=\left(\frac{7+9}{2},\frac{9+9}{2}\right)=(8,9) \\ \boldsymbol{\mu}_2^{\mathrm{new}}&=\left(\frac{1+2+3+8}{4},\frac{3+2+4+7}{4}\right)=(3.5,4) \end{aligned} \] となる。 更新後の代表点に対して割り振り直すと、次のようになる。 例えばEでは\(4<29.25\)となるため、クラスター2からクラスター1へ移る。
| 点 | \(\Vert\boldsymbol{x}-\boldsymbol{\mu}_1^{\mathrm{new}}\Vert^2\) | \(\Vert\boldsymbol{x}-\boldsymbol{\mu}_2^{\mathrm{new}}\Vert^2\) | 割り振り先 |
|---|---|---|---|
| A | \(85\) | \(7.25\) | \(2\) |
| B | \(85\) | \(6.25\) | \(2\) |
| C | \(50\) | \(0.25\) | \(2\) |
| D | \(1\) | \(37.25\) | \(1\) |
| E | \(4\) | \(29.25\) | \(1\) |
| F | \(1\) | \(55.25\) | \(1\) |
したがって、求める代表点は\((8,9)\)と\((3.5,4)\)、その代表点への割り振りによるクラスター1は\(\{D,E,F\}\)、クラスター2は\(\{A,B,C\}\)である。
散布図では、各点の位置をそのままにして、代表点と割り振り先の変化を示す。 丸印がクラスター1、四角印がクラスター2を表し、大きな輪で囲んだ位置が代表点である。 左図の初期割り振りではEはクラスター2に属するが、代表点を更新して割り振り直すと、右図のようにクラスター1へ移る。
[4]
クラスターのまとまりの良さは、各点と所属する群の代表点との距離の二乗を足したクラスター内平方和で測る。 各マンションに番号\(i\)を付け、その座標を\(\boldsymbol{x}_i\)とする。 群\(j\)に属するマンションの番号の集合を\(C_j\)、その代表点を\(\boldsymbol{\mu}_j\)とすると、k-means法が小さくする量は \[ W=\sum_{j=1}^{k}\sum_{i\in C_j}\|\boldsymbol{x}_i-\boldsymbol{\mu}_j\|^2 \] である。 割り振りを固定したとき、群\(C_j\)の平均を\(\bar{\boldsymbol{x}}_j\)、点の数を\(|C_j|\)とすれば \[ \sum_{i\in C_j}\|\boldsymbol{x}_i-\boldsymbol{\mu}_j\|^2=\sum_{i\in C_j}\|\boldsymbol{x}_i-\bar{\boldsymbol{x}}_j\|^2+|C_j|\|\bar{\boldsymbol{x}}_j-\boldsymbol{\mu}_j\|^2 \] と分解できる。 右辺の第2項は非負なので、代表点を群の平均とすることで、この群の平方和が最小になる。 一方、代表点を固定したときは、各点を最も近い代表点へ割り振ることで、その点が平方和に加える値を最小にできる。 この二つの操作がk-means法の更新に対応する。
初期値依存性とは、同じデータとクラスター数でも、初期代表点の選び方によって最終的なクラスターが異なり得ることである。 各更新で平方和は増加しないが、更新しても値が変わらなくなった分割が、考え得るすべての分割の中で最も小さい平方和をもつとは限らない。 そのため、出発する代表点によって異なる分割に落ち着くことがある。 対策として、初期代表点を変えて複数回実行し、クラスター内平方和が小さい結果を選ぶとともに、分類が安定しているかを確認する。